我一直想要一个能持续理解同一个人的 Agent。
ChatGPT 上线记忆的时候,我喜欢那个效果:不用每次重新自我介绍,它记得你惯用的技术栈、说话习惯和正在做的事。产品本身是黑盒。我答不上来它记住了哪一条、为什么留、什么时候会忘。做 Biny 时我把记忆做成可以打开、可以逐条改的数据,每条都能查出从哪来。
动手前我看了 Codex 的后台两阶段归并、Claude Code 的项目笔记、OpenClaw 的文件人格加 Dreaming,还有 mem0 的条目化事实。基本单位用的是 mem0 那种:把还能复用的事实抽成独立条目,再放到本地,按层存放,批量维护。
下面按一条信息从哪来、存到哪、什么时候被取出来、怎么被清掉来写。
整体架构
长期要留的东西不止事实。当前任务、给人读的长文本、反复出现的对象、电脑上实际做过的事,活多久、证据从哪来,都不一样。我把它们拆开存,各管各的整理,拼 prompt 的时候再放到一起。
回答的时候只按相关性捞几条事实。全库去重、过期、语义合并不放在这一轮,交给 Sleep,默认本机 03:00 之后、runtime 空闲时跑。
| 层 | 记什么 | 怎么被用到 |
|---|---|---|
| 短期工作记忆 | 当前做到哪、还剩什么 | 会话历史与压缩、Thread Brief、项目卡、Todo 与执行状态 |
| 长期事实 | 偏好、约束、稳定背景 | SQLite 事实条目;本地向量做语义 Top-K;Sleep 在后台巩固 |
| 时间证据 | 原话何时说出、相对日期指哪一天 | 挂在事实的来源锚点上,同文不同来源不直接合并 |
| 文件记忆 | 画像、日记、人格 | USER.md、MEMORY.md、近两天日记、SOUL.md 按约定注入,不做 Top-K |
| Crystal | 反复出现的项目和概念 | 累计提及与分布,过门槛后再整理成带材料的对象 |
| Activity | 电脑上实际做过的事 | 本地事件与 OCR;整理成工作记录,只有少数候选再进事实库 |
事实是主数据,embedding 是可以重建的索引。聊天历史另有全文检索,和事实召回各走各的,不做混合排序。
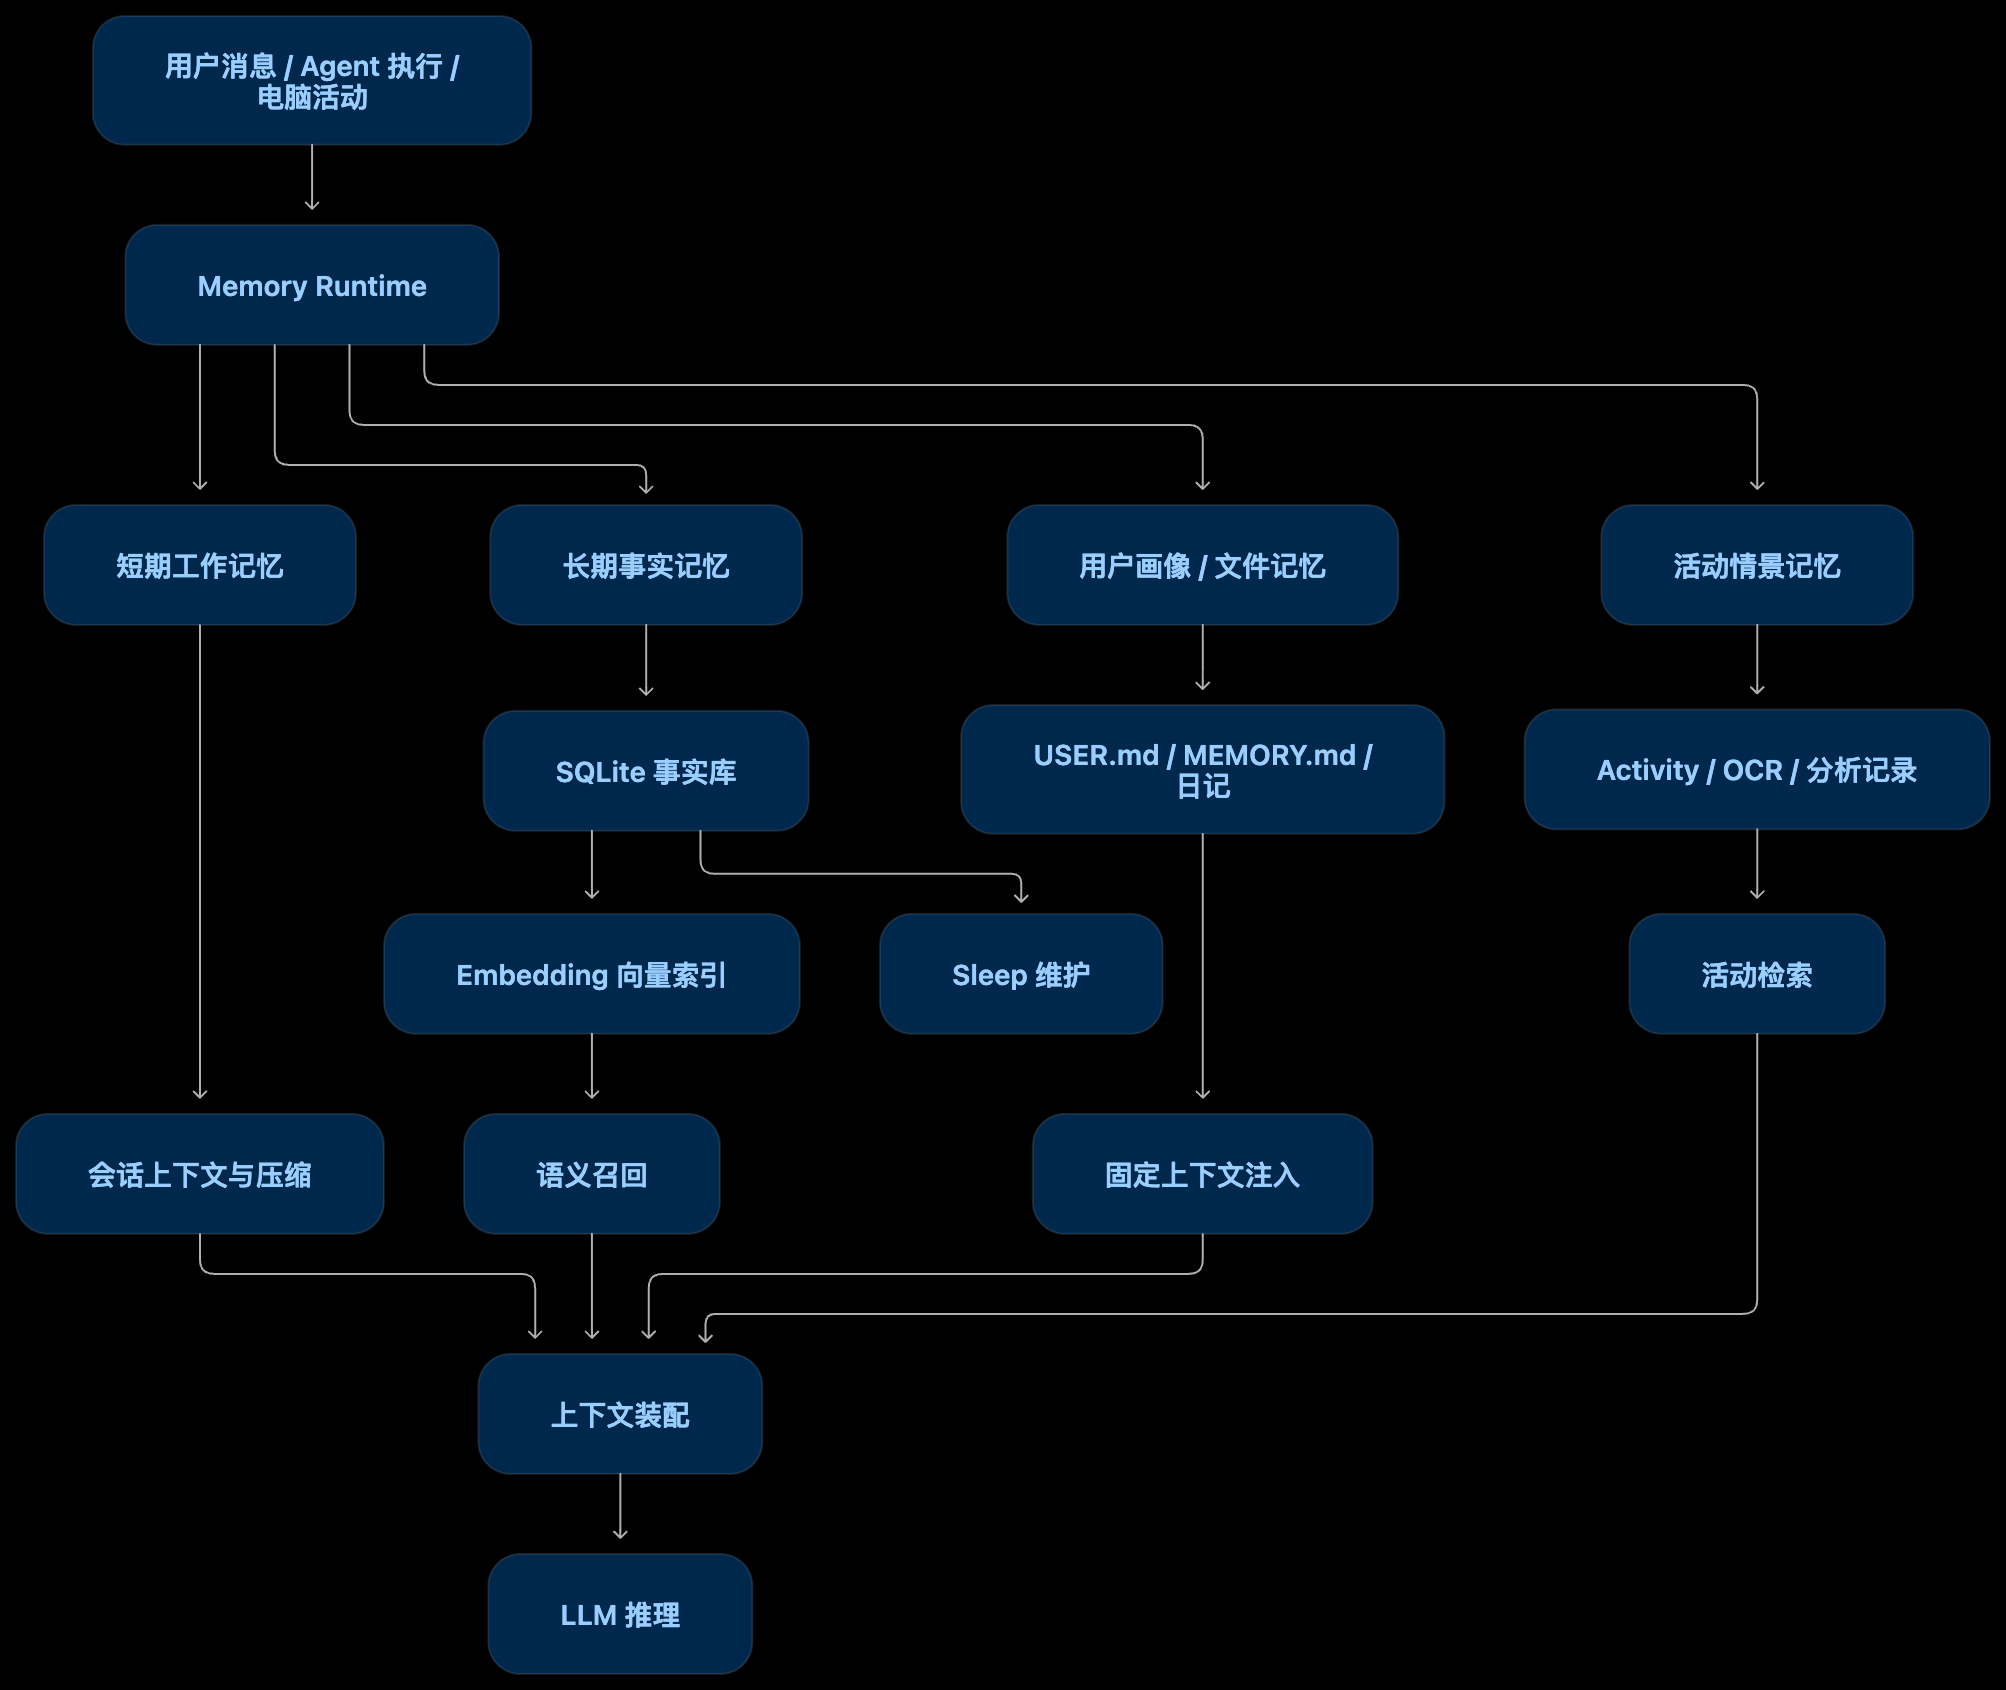
Biny 记忆系统总览:用户消息与电脑活动进入 Memory Runtime,短期工作记忆、长期事实、文件记忆与 Activity 在上下文装配处汇合;时间证据挂在事实上,Crystal 挂在长期知识旁边
图 1:几条主路径在拼 prompt 时汇合。时间证据写在事实上,Crystal 单独放。
短期工作记忆:让当前任务能接着做
短期工作记忆管的是任务能不能接着做。你说“检查一下这个项目的登录接口”,Agent 查完,你接着说“把刚才发现的问题修复一下”。第二句没有路径,也没有细节,只能靠当前会话才知道指什么。
这里有两件不同的事:
- 上下文还在:对话很长,或者已经压缩过,模型仍知道当前在做什么。
- 执行还能续:任务中断、进程退出,或者换了一个执行者,还能从断点接着做。
模型记得下一步,不表示系统能安全地把工具调用续上。
我用了四层来配合这件事,粒度依次变粗:单会话内、会话级、项目级、任务级。

短期工作记忆的四层:会话历史与压缩、Thread Brief、项目卡、Todo 与执行状态
图 2:四层管的粒度不同,换一层顶不了另一层。
第一层:会话历史 + 压缩
同一会话能持续工作,我靠这一层。
我把消息按树存在会话日志里。每条我记下编号、上一条是谁,以及它属于回答里的哪一个位置。同一个位置可以有多个版本。恢复时我从当前这条分支拼上下文,不把文件里的全部文本按时间接起来。你改了问题、重试了回答,旧版本还能切回去,但我不拿它参与新分支的推理。
上下文快到模型上限时,我把较早的对话换成一份结构化摘要,最近一段原始消息留着。
关键在于这份摘要不是“我们刚才聊了什么”,它有固定的字段:
| 字段 | 记录什么 |
|---|---|
| Goal | 当前目标 |
| Constraints & Preferences | 约束和偏好 |
| Done | 已完成 |
| In Progress | 正在进行 |
| Blocked | 被卡住的部分 |
| Key Decisions | 已做的取舍 |
| Errors & Fixes | 遇到的错误和修法 |
| Next Steps | 下一步 |
最重要的是后面几项。假设压缩前正在修一个超时问题,摘要里应该长成这样:
| 栏 | 写什么 |
|---|---|
| 目标 | 修复工具调用超时 |
| 已完成 | 定位超时处理代码,新增失败测试,改完超时取消逻辑 |
| 进行中 | 单元测试已通过,集成测试还没跑 |
| 下一步 | 跑集成测试,检查是否引入了重复工具调用 |
压缩之后,模型不一定还能看到最早的完整对话,但它知道做到哪、还剩什么、下一步是什么。一份“研究了登录问题,进展顺利”读起来更短,可它指导不了后面的工作。
已经有摘要时,我把旧摘要和新对话合在一起,不从零再写一份。
触发线我不写成死的 80%。我先看显式保留量,再看触发百分比,最后才退到模型参考线或动态保留量。压完没有省下 token,我不发布新的检查点。摘要失败,我留着原历史,并进入冷却。
检查点我不放进正式历史,也不提升成系统指令。模型自己写的摘要,不能变成你的新授权。
摘要可能漏细节,文件也可能在这期间被改过。这一层续不上工具执行。
第二层:Thread Brief,会话级工作摘要
压缩是我给当前这次对话腾上下文。Thread Brief 是我事后整理这条会话,记下它主要在做什么。
我默认等这轮完成后再放进队列,不在回答的时候做。门槛是:至少 2 个你的轮次;队列最多积 64 个,我一个一个做;同一条会话已经在排队或正在整理,我不再排一次;内容没怎么变,新增不足 400 字,我沿用旧摘要。我不会每轮都调模型。
送进去之前我截断:你的一条最多 1200 字,助手 400 字,总共 12000 字,超出就留后面的。小模型按我规定的结构写:
CodeBlock Loading...
后续行动里符合条件的,我转成待办,并带来源原话。隔一天再开一条会话,我靠这个看出这条线做到哪。
第三层:项目卡,跨会话的工作记忆
今天关掉会话,明天新开一条还想接着做,我靠这一层。
每个工作区我存一份项目卡:
CodeBlock Loading...
长期背景我写这个项目是什么,当前焦点我写这一阶段在推什么。同一个项目下新开一条会话,我把已经确认过的背景和焦点放进去。
模型不能直接改已确认的项目卡。它可以提议,更新要你点头。聊几句就把项目目标改掉,这个我不要。
第四层:Todo 与执行状态,真正记录“还剩什么”
前面三层是让模型知道当前在做什么。真要接着执行,还得有写到磁盘上的任务状态。
待办是其中最小的一份。我存一份带状态的清单,每条有内容和状态,最多 50 条、每条 500 字,同时只允许一条标成进行中。每次我整份替换,不按序号改一条。这样不会出现「第 3 条到底是哪个」。
有内容时我把它拼进提示,并要求:开始做的标成进行中,真正做完才标完成。还有没做完的,不能说工作已经结束。
比待办更重的是执行断点。我把这一步的消息、系统提示、步骤数、预算和高水位写进 TurnStore,用临时文件写完再改名,并同步目录。恢复时我读的是这份状态,不是一段摘要。
中断之后我先核对高水位,再从日志和外部调用记录里补齐已经有结果的步骤,不重放动作。已经提交的终态,我优先于旧断点。结果未知、缺必要输入,或者需要新授权时,我停住,返回阻塞。
一次外部写入发出去了但没收到回执,远端可能已经做完。这时重试会做两次。我记下「未知」,停下来查,不把它当成失败。
三种“接着做”,靠的不是同一套东西
| 场景 | 主要机制 | 恢复粒度 |
|---|---|---|
| 同一会话聊得太长 | 压缩 checkpoint | 对话上下文 |
| 换个会话继续同一个项目 | 项目卡 + 会话整理 | 项目目标和工作焦点 |
| 任务中断或换执行者 | Todo + TurnStore + 执行记录 | 任务进度和操作证据 |
会话整理我用来看这条线在做什么。它不是执行检查点。
压缩让模型知道做到哪。执行状态决定能不能安全接着做。这两件我分开建。
长期事实记忆:不是聊过就必须存
这是我花时间最多的一层。整段对话不进数据库。
一条事实我这样走:
- 一轮生成结束后,我只取结尾几条你和助手的话,不把整个会话送去提取。
- 我让小模型看里面有没有以后还能用的稳定事实。没有它就返回不记。一轮我期望 0~2 条。你明确要求忘掉或纠正时,它可以给出删除。
- 要留的我写成一条独立事实,放进 SQLite。正文是主数据。
- 我用本地模型给这条正文算一个向量,写进同一个库,下次按相似度找。
- 你下一轮再问,我先把问句改写成检索说法,再算向量,按相似度取几条,放进这一轮。
- 每天凌晨我用 Sleep 扫整张事实表,做去重、过期和合并。收掉的放进归档,不直接抹掉。
提取是我在产生新事实。Sleep 是我在整理已经入库的事实。两件事我不放在同一轮。
我收的是偏好、长期约束、稳定背景和还在做的项目。寒暄、临时问题和一次性任务我丢掉。
我看的是这条信息以后还用不用得上。稳定的身份、偏好、长期目标和做事习惯我可以记。当前任务的细节、一次性请求、只在这一轮有用的话,我丢掉。你明确说忘掉、纠正,或者某条已经不成立,我可以删,不只是一直往上加。
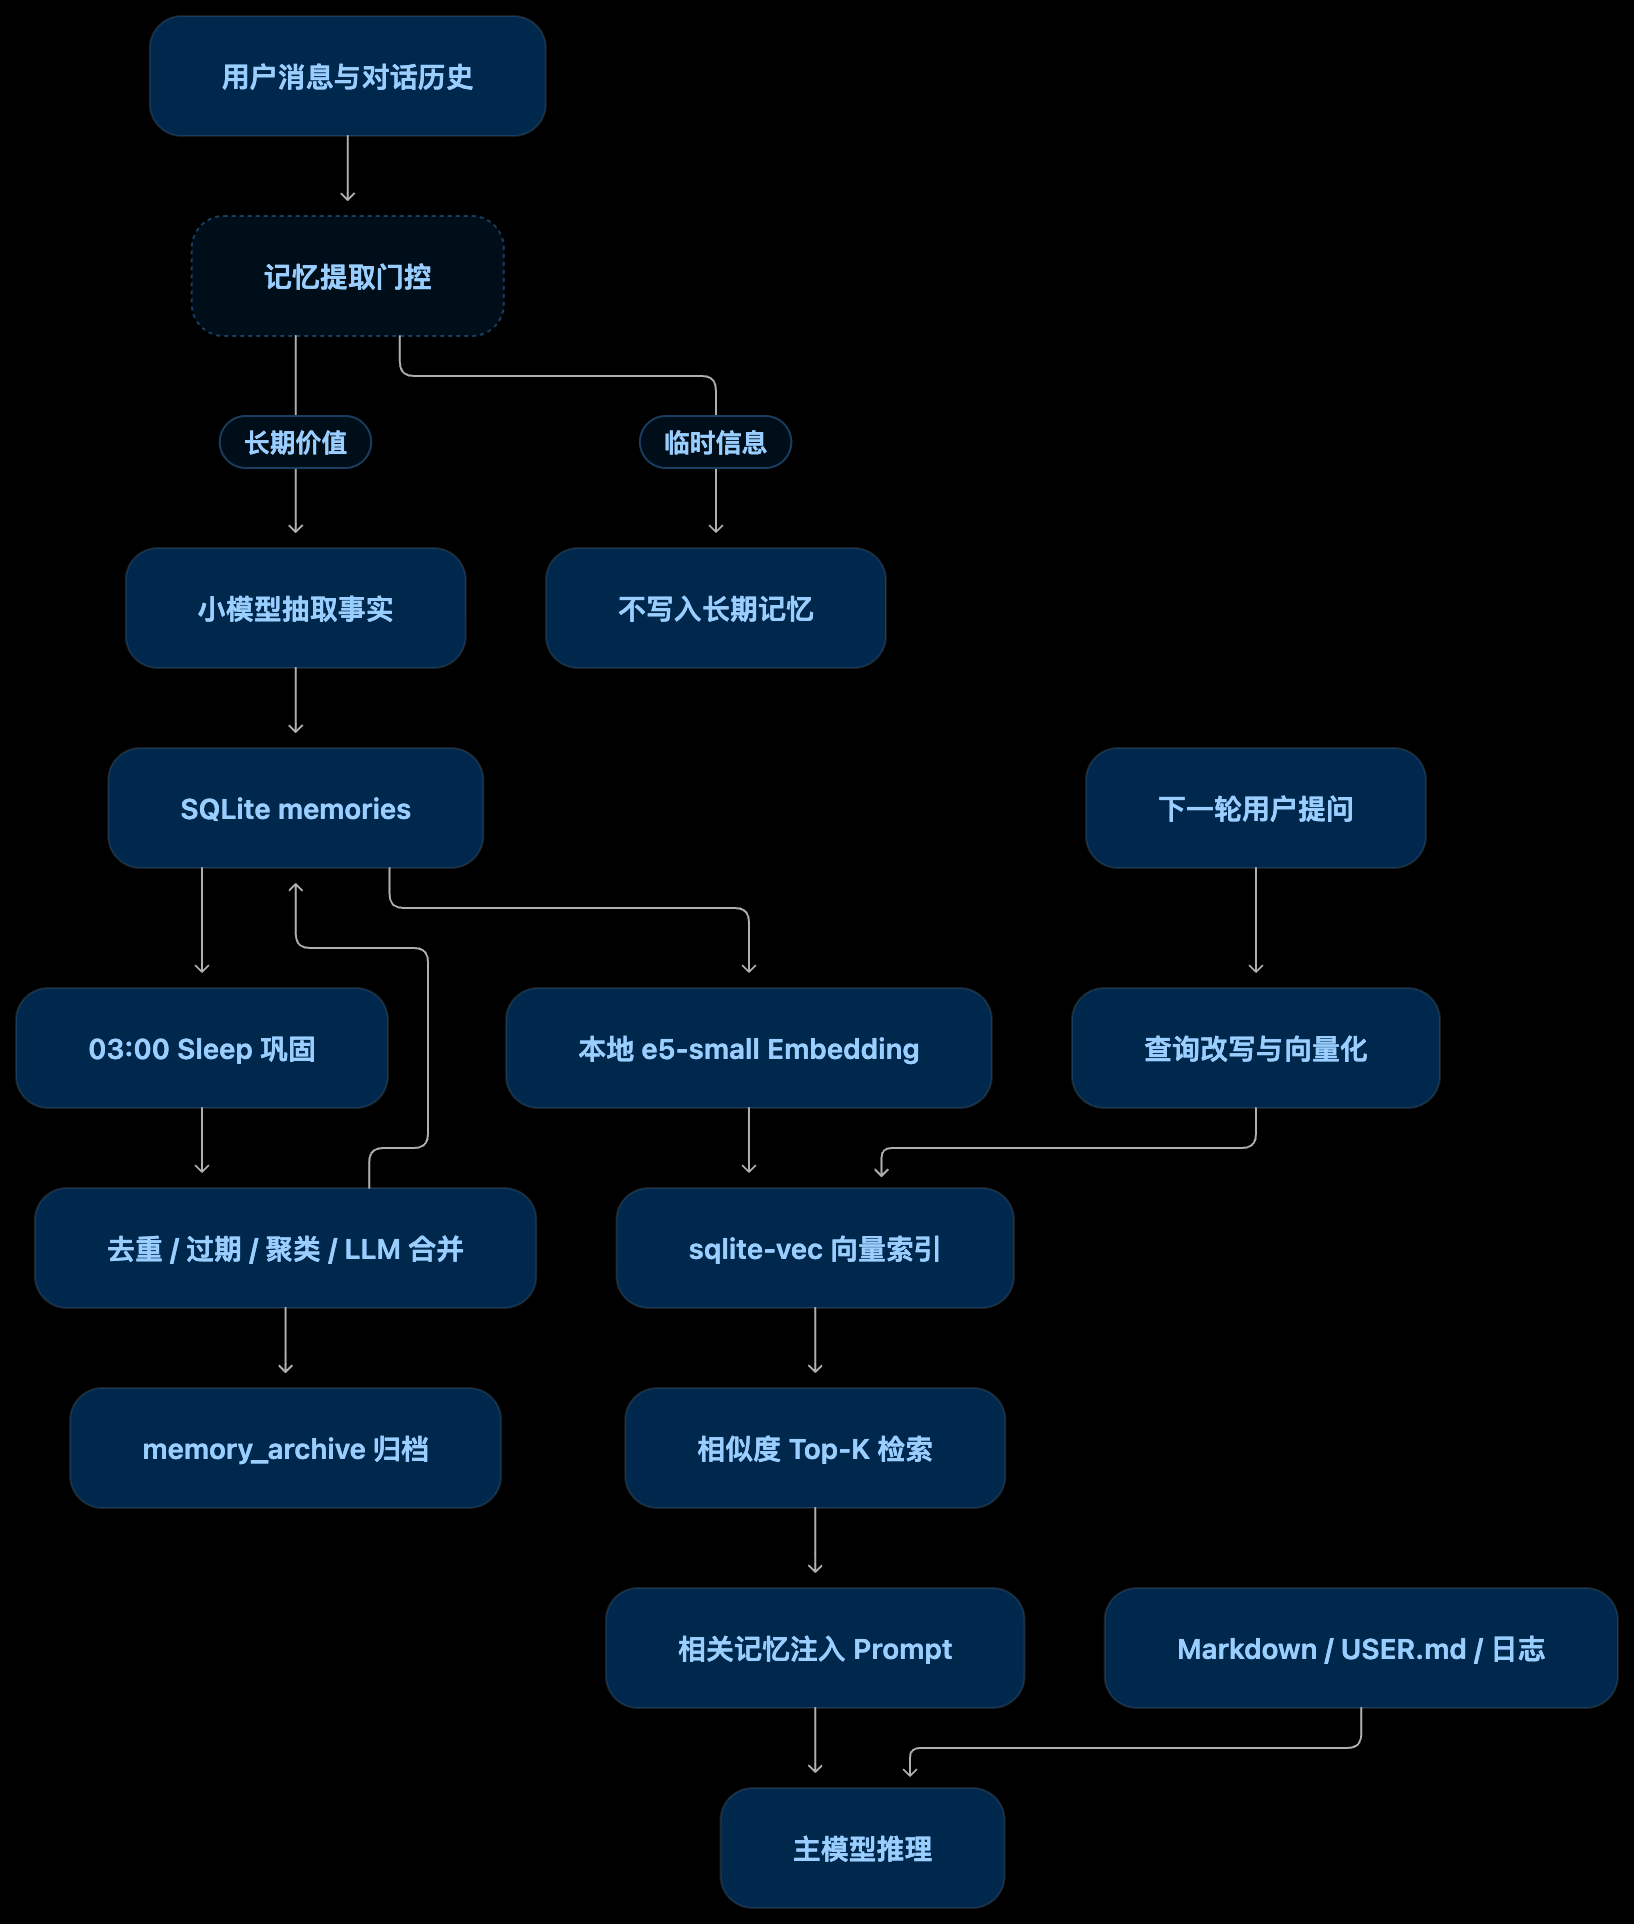
事实的记忆生命周期:提取门控分流长期价值与临时信息,长期价值进入小模型抽取与 SQLite,随后分别流向向量召回与 Sleep 巩固两条路径
图 3:写入之后分成两路,一路给下一轮召回,一路等 Sleep 整理。
一条事实长什么样
存储形态是 content 加一段 metadata JSON,不是知识图谱。
| 字段组 | 关键字段 | 作用 |
|---|---|---|
| 内容 | id、content | 稳定标识与正文,正文最多 2,000 字符 |
| 分类 | source、tags、rationale、importance | 来源、组织方式、保存原因、重要度 |
| 生命周期 | durability、expiresAt | 区分临时事实和长期事实,表达显式到期 |
| 来源关联 | threadId、messageId、userId | 关联会话、消息、用户空间 |
| 原始时间证据 | originAnchors | 原消息 ID、发送时间、发送时区 |
| 版本 | revision、createdAt、updatedAt | 支撑异步工作后的版本核对 |
| 使用统计 | accessCount、lastAccessedAt | 参与后续维护判断 |
| 归档关系 | originalId、archivedReason、mergedInto | 解释何时、为何、被谁归档,合并去了哪 |
重要程度默认 0.5,标签最多 12 个,来源锚点只取输入的前 32 个再去重。正文有长度上限,长材料不往这里塞。
从原话到一条事实,中间大概是这样:
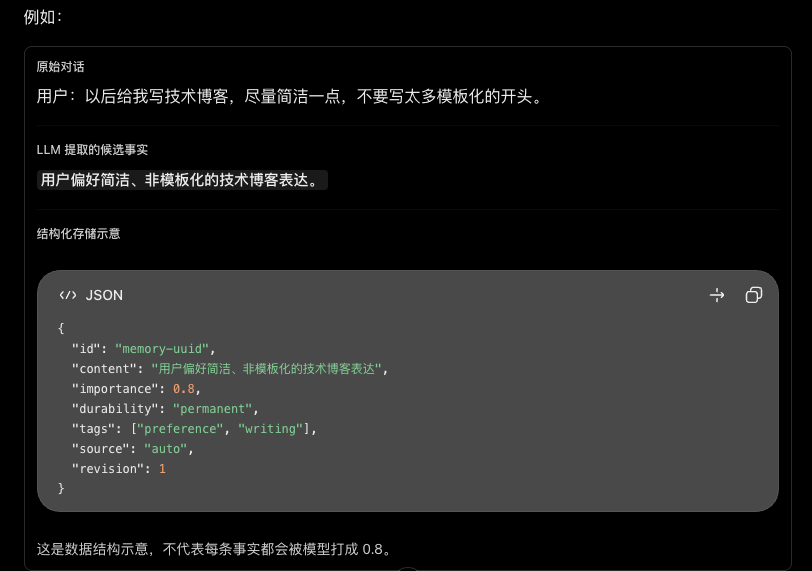
示例:用户说「以后给我写技术博客,尽量简洁一点,不要写太多模板化的开头」,LLM 提取出候选事实「用户偏好简洁、非模板化的技术博客表达」,再存成带 id、content、importance、durability、tags、source、revision 的 JSON
图 4:原话不原样存。存进去的是一条可以单独检索、单独改的事实。
来源时间和保存时间必须分开
这一点我故意拆开了。
你在周一说“下周五发布”,两周后 Sleep 才整理这条记忆。这时有三个时间:
- 保存时间:这条记忆什么时候写进库;
- 原话说出的时间:挂在来源锚点上;
- 当时的时区:用来解释“明天”“下周五”。
Sleep 跑的那天,不能拿来重算旧消息里的“明天”。精确去重分组时,来源锚点也算一条判据:正文一样、锚点不同,不合并。两周前那个“周五”和两周后那个“周五”字面相同,不是同一件事。
时间不单独做向量。它写在事实的 metadata 里,召回时跟着事实走,去重时用来挡住这种合并。
写入前先做语义判重
自动新增时我先做这些:
- 清洗候选正文和附带信息;
- 在同一个用户空间里找最相近的 5 条,最低相似度 0.3;
- 让模型判断它是同一事实、已有事实的子集,还是更含糊的重复说法;
- 重复我就跳过,有实质新增才写入。
这不是严格去重。模型判断失败时我可能继续新增。新内容更丰富,我也不一定会改旧的那条,可能直接再写一条。手动新增我不做精确去重,每次合法新增都是一条新记录,同样的正文可以并存,留给后面的 Sleep。
召回:一条事实怎样回到当前回合
召回我放在每一轮真正生成之前,不扫全库:
- 我把你的问句交给小模型,改写成面向已存事实的检索说法。超时或失败,我用原句。
- 我用本地模型把这句算成向量。
- 我在向量表里按余弦相似度排序,取最靠前的几条,默认 5 条,低于 0.1 的不要。你问「你还记得我是做什么的吗」,我改写之后更接近
User works as occupation job,再拿这句去比库里的「User is a backend developer who prefers Go over Python」。 - 我按编号再读一遍事实表。已经删掉、已经归档,或者正文在等待期间被改过的,我丢掉。
- 剩下的我按字符和这一轮的 token 预算裁剪,整条放在当前问题前面当参考。写回聊天历史时我再剥掉,免得下一轮把它们当成新经历再学一遍。
命中之后我记下这条被用过。这个计数我留给后面的维护,不拿来排这次的序。这次只看相似度。聊天记录我另有全文检索,那是查原话,不和事实召回混成一次排序。
召回比写入整齐。

召回链路:查询改写、生成 Query Embedding、向量 Top-K、范围与版本复核、预算裁剪、注入推理
图 5:先按相似度排名,再过范围、版本和预算。
查询改写我默认开着,单独用一个小模型:最长 3 秒,输出很短,不做推理。改写结果我让它偏向英文检索说法,标识符、路径和技术词原样留下。失败我就用原来的问句。
我做这步,是因为「你还记得我平时怎么写文章吗」和「用户偏好的写作风格」在向量空间里差得很远。改写把前者往后者推。
向量我默认在本地算:multilingual-e5-small,384 维,Transformers.js + ONNX,另有 MiniLM 可选。搜索不打远端的向量接口,断网也能查。
默认的自动召回参数是这三个:Top-K 记忆条数 5、相似度门槛 0.1、Embedding 维度 384。
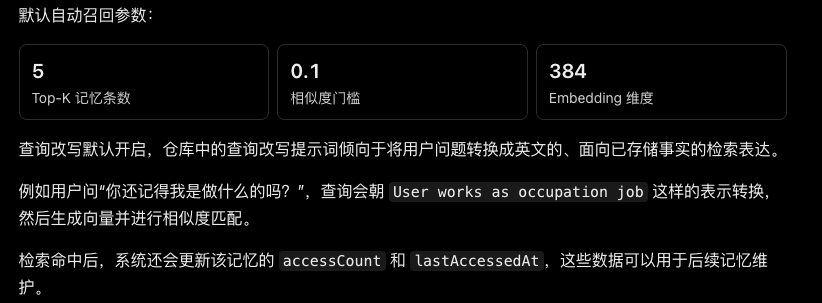
默认自动召回参数:Top-K 记忆条数 5、相似度门槛 0.1、Embedding 维度 384
匹配就是一次 cosine 排序:
CodeBlock Loading...
同一套 cosine,门槛不一样
下面只列写入和召回。Sleep 的 0.75 和 0.95 在后面。
| 使用场景 | 候选数量 | 门槛 |
|---|---|---|
| 自动事实召回 | 5 条(可配 1–20) | 0.1 |
| 显式 recall 工具 | 5 条 | 0.3 |
| 自动新增判重 | 5 条 | 0.3,再让模型判断 |
| 按描述删除事实 | 10 条 | 0,再让模型精确选择 |
| 回合后清理临时事实 | 20 条 | 0.3,再让模型选择 |
这些是相似度门槛。换一个 embedding 模型,同一个数的含义就变了。它们不是“这条事实有多正确”。
检索完还要再确认一次
查询改写和生成 embedding 都是异步等待,这期间你可能刚好编辑或删掉了那条事实。所以候选回来之后,我会按 ID 重新读一遍选中的活动事实:
- 已经删除 → 丢弃;
- 已经归档 → 丢弃;
- 版本号变了 → 丢弃;
- 只有访问统计变了 → 保留。
防的是检索开始时还在、返回时已经过期的事实被送进模型。丢掉的名额不补。
预算有两层。事实召回自己有 12,000 字符上限,还要再服从这一轮的 token 预算。放不下就停,一条事实不切成半条。注入的内容放在当前用户消息旁边当参考,写回历史时剥掉,免得下一轮把旧记忆再学一遍。
向量可以重建
事实是主数据。embedding 丢了可以重算。
向量我用 sqlite-vec 存在同一个库里,只针对事实正文,不把全部附带信息算进去。我用几层校验守住它:
- 模型指纹和维度必须匹配;
- 向量的版本必须和活动事实的版本号对应;
- 异步算完回来,写入前我再查一次事实版本;
- 更新事实时我先去掉旧向量,再算新的;
- 重建我按 64 条分批,做完再看整张事实表变没变;
- 最后替换向量索引时,我在事务里再对一遍条数和版本。
所以很晚才回来的旧向量盖不掉新事实,删掉的事实也不会因为旧向量又出现。
事实写成功、索引失败时,我不回滚事实,它只是暂时搜不到。召回我返回空,并带上降级原因。文档里写过可以退回文本检索,调用链没接上,我不当它已经能用。
Sleep:为什么整理要放到后台
Sleep 我不拿来看当天的聊天。我只扫已经在事实表里的条目。默认每天本地时间凌晨 3 点。那时候机器关着,下次打开我补跑当天这一次,不把缺的每一天都重放一遍。
一轮我按这个顺序做:
- 正文规范化之后完全一样的,我留一条,其余归档。
- 临时事实我按到期和有没有被用过清理。长期事实不因为放得久就删。
- 我用已有向量把相近的事实收成簇。特别像的直接并。剩下的交给小模型决定删、留,还是合成一条新的。
- 归档超过保留期的,我再物理删除。
写入时我已经判过一次重。跨记忆的去重、合并还要扫很多事实,反复调模型。塞进回答这一轮,你会等,也和你正在做的事抢机器。
所以提取和批量维护我分开。前台我只做提取和判重。Sleep 我放到本机 03:00 之后、runtime 空闲时跑。你开始干活,我就让开。
我只动已经入库的事实。不重放当天的聊天,不分析截图,不改用户资料,也不训练。

Sleep 四个阶段:精确去重、临时事实过期、相似整理、归档清理
图 6:四个阶段按顺序跑。前一个出错,后面停,免得整理失败了还把恢复来源删掉。
第一阶段:精确去重
比较前做 Unicode NFC、合并连续空白、去掉首尾空白。大小写和标点的差别留着。分组还带上用户空间和来源消息锚点。
插入的时候不做这些。库里的正文就是提取模型给出的那句。比如连续两轮得到几乎同一句,只是第二句末尾多了一个空格,活动表里是两行:
| 编号 | 正文 |
|---|---|
| m-1 | User prefers TypeScript and pnpm. |
| m-2 | User prefers TypeScript and pnpm. |
第二行末尾多了一个空格。
Sleep 比的时候把首尾空白去掉,两句算同一句。同一个用户、同一个来源,就留被用得更多的 m-1,m-2 挪进归档。m-1 的正文不改。
| 去向 | 编号 | 正文 | 说明 |
|---|---|---|---|
| 活动表 | m-1 | User prefers TypeScript and pnpm. | 留下 |
| 归档 | m-2 | User prefers TypeScript and pnpm. | 精确重复,并进 m-1 |
如果一个是 TypeScript,另一个是 typescript,大小写不同,这一阶段两条都留着。
有两处特别的保护:
- 来源锚点不同的同文事实,不直接精确合并;
- 没有来源锚点的临时事实,用自身 ID 区分,不按同文合并。
分组后留一条,其余归档,原因记成精确重复,并记下并进了哪一条。
第二阶段:临时事实过期
临时事实的默认保存期限是 30 天,但实际判断看的是另一组条件:
| 条件 | 结果 |
|---|---|
| 不是临时事实 | 不受这条规则影响 |
| 写明的到期时间已经过了 | 过期,即使被访问过 |
没有显式到期,但 accessCount != 0 | 不按年龄 TTL 过期 |
| 从未被访问,且创建已超过 30 天 | 过期 |
过期的是:临时事实存了超过 30 天,而且一次都没被算进访问。不是“30 天没人看就过期”。没有按最近一次访问时间往前滑动的遗忘窗口。
第三阶段:相似整理
这一阶段重新读取活动事实,按用户分开,用已有的有效向量两两算 cosine:
- ≥ 0.75 的边用来形成连通簇;
- 超过 50 条的簇直接跳过;
- 先看能不能直接相似归档;
- 剩下的按默认 20 条一批交给模型。
直接归档有两道限制。第一,簇里只要有临时事实或来源锚点,就不走纯向量直判。第二,选定要留下的那条之后,只有和它有 ≥ 0.95 直接相似边的事实才归档——不能因为 A 连着 B、B 连着 C,就把 C 一起带走。
留哪一条按这个顺序比:先看是不是长期事实,再看重要程度,再看被用过多少次,最后用更新时间分胜负。长期事实有固定的优先,所以不是单纯留最新的,也不是单纯留被用得最多的。具体加权数字在现有记录里没有还原出来。
两条都在活动表里,字面不一样,精确去重不会动:
| 编号 | 正文 |
|---|---|
| m-1 | User mainly uses TypeScript and Node.js. |
| m-2 | User's backend projects are primarily TypeScript and use pnpm. |
相似度落在 0.75 和 0.95 之间,我交给小模型。它返回一份计划:删掉 m-1 和 m-2,合成一条「User's main stack is TypeScript and Node.js; backend projects use pnpm.」。改库的是我。新句子我写进活动表,旧的两行进归档,并指向这条新事实。模型没给替代句子却要求两行都删,这次我不执行。
模型只给我一份计划:哪些删,哪些合成。簇外面的编号我丢掉。它想把整簇删光又没有替代事实,我忽略。说了合成不等于删除,只有点名要删的我才归档。模型多给的到期时间我不收。合成事实我要先算好向量,这步失败就留着原事实。这一批里任意一条合成失败,原事实我都不归档。
合并我没做成一次事务。新事实写入、向量保存、旧事实归档是三次提交。中途失败会新旧并存。多条合成时,归档记录我只指向其中一个新事实。提示词要求尽量不丢信息,我没有证明过零损失。
第四阶段:归档清理
归档超过 30 天的记录,我物理删除。我按归档时间算,不按原事实的创建时间。前面的存储阶段出错,我停住后面的阶段。整理失败了,我不能再把恢复来源删掉。
模型判断期间,数据已经变了
想象这个顺序:
- Sleep 读到事实 A,
revision = 5; - 把 A 交给模型,判断它是否应该被合并;
- 模型思考的几十秒里,你顺手把 A 改了,版本号变成 6;
- 模型返回“归档 A”。
我如果只按编号归档,会删掉你刚改过的新版本。把归档包进一个事务也不够。事务只保证这次提交要么全成要么回滚,不管模型看到的还是不是现在这份数据。
所以我把保护拆成三层:

三层保护:SQLite 事务保证提交原子性,owner lease 保证执行权,expectedEntries 保证模型看到的事实没有过期
图 7:事务、租约、版本核对各管一件事。
同一个进程里,维护还在跑,我就不再开一轮。取消时我发一个中止信号。多个进程之间我用 SQLite 里的一把共享租约:
- 租约 60 秒有效,我每 15 秒续一次;
- 每次写入我都带上持有者标记;
- 租约失效或被拿走之后,旧的那次不能再提交。
真正提交时,我在事务里再对一遍当时看到的条目:还在活动、版本号没变、正文没变。有一项对不上我就拒绝。临时事实过不过期,我也在事务里再判一次。访问次数变了不会改版本号,我只对版本号,发现不了「扫描之后刚被召回」。
模型的判断可能已经过期。我提交时再拿当前数据对一次。这是乐观并发。
文件记忆、画像与人格
长文本、用户画像、说话方式,我不放进事实表。这一层我不检索。每次拼提示时,我按文件在不在、内容空不空决定读不读。
文件我放在 ~/.config/biny/:
| 文件 | 我什么时候读 | 我放在哪 |
|---|---|---|
| 用户画像 | 文件存在且不是空的。工作区里有同名文件,我用工作区那份 | 系统提示 |
| 长期备忘 | 不是空模板 | 贴在最新的用户消息前面 |
| 今天和昨天的日记 | 当天、昨天的日期文件存在且不是空的。更早的我不在这里读 | 和长期备忘放在一起 |
| 人格文件 | 有自定义内容 | 换掉我内置的人格 |
| 人物笔记 | 不在这条自动加载里 | 模型要用时自己去读 |
用户画像我放进系统提示。长期备忘和近两天日记我合成一块,跟在当前问题上。这里我不用向量挑段落,符合条件的文件整份放进去。更早的内容,要靠记忆搜索和会话搜索再查。
拼基础提示时,我按固定顺序读 MEMORY.md、今天的日记、昨天的日报,三者合计不超过 32,000 字符。顺序固定,长期备忘太长会挤掉近期日记。三个来源我没有各自留一份额度。
USER.md 是独立的用户资料。我给它版本号、内容校验和历史文件。保存时要带上你看到的那个版本号,对不上我拒绝,避免两个界面互相覆盖。SOUL.md 是可选的自定义人格。没有这份文件,我用内置人格,不生成一份默认副本。
反思我只改已经存在的自定义人格,而且只动演化出来的特征:要有证据,单条最多 500 字,总共最多 15 条,每个自然日最多新增 1 条。修订或删除,我核对已有特征的版本号。改的是提示里的文字,不是模型参数。
日记我另算。普通聊天结束我不写每日笔记,要显式触发。回补时我用会话和回合的稳定键去重。反思可以读日记、允许的活动记录,以及最多 40 条辅助事实。已经是反思产物的,还有明确来自活动记录的事实,我排除,避免读到自己刚写的东西再写一遍。一次我最多收 3 条长期事实候选、2 项未完成承诺对应的行动。我先把草稿落盘,再逐项记下副作用有没有完成。抛异常的步骤,下次同源刷新时我重试。
定时提醒我默认关闭,打开后默认 30 分钟一次。它不调用模型写日记,只提醒该去做。
Crystal:反复提到的东西
我不用 Crystal 存事实,也不给它建关系边。事实里记「你在做某个项目」。我要做的是把这个项目长成一张可以引用的卡片。
一轮生成结束后,我看还有没有没处理过的用户消息。有的话,隔 400 毫秒做一次挖掘。我不会每轮都新建一张卡。
- 我先拿已有卡片的名字去对这句。对上了,就把这句挂成材料。
- 没对上全名,我拿这句最多 800 字和卡片描述做点积。到了 0.62,我也挂上。所以「小王」和「王工」可以进同一张卡,不必先把全名再说一遍。
- 然后我让小模型只抽你自己用的称呼,2 到 24 个字。泛词我丢掉。
- 同一个称呼我按出现次数、跨了多少轮、跨了多少会话或多少天累计。三项都过线我才升级。你只在一个会话里反复提,我不当它已经稳定。
- 到了核心门槛,我生成一张候选卡,把相关的话都挂成材料。
- 小模型按类型补字段。我要求每条都能指回这次给它的材料,指不回的丢掉。我再检查必填和引用。
- 确认我单独做。这一轮我不会自动把它变成正式卡。正式之后,对话里才能当实体引用。14 天没有更新,我让它休眠。
我按这个门槛升级:
| 我把它从哪挪到哪 | 条件 |
|---|---|
| 苗头到轮廓 | 提及 ≥ 4 次、跨 ≥ 3 个回合、分布 ≥ 2 |
| 轮廓到核心 | 提及 ≥ 8 次、跨 ≥ 5 个回合、分布 ≥ 2 |
| 自动休眠 | 14 天无更新 |
| 阶段 | 条件 |
|---|---|
| 苗头到轮廓 | 提及 ≥ 4 次、跨 ≥ 3 个回合、分布 ≥ 2 |
| 轮廓到核心 | 提及 ≥ 8 次、跨 ≥ 5 个回合、分布 ≥ 2 |
| 自动休眠 | 14 天无更新 |
分布我取会话数和日期数里较大的那个。跨两个会话,或者跨两天,我都算它铺开了,不要求两样同时达到。同一个词在同一次出现里我只计一次。
主题稳定之后,我按类型让它填清单:实体、概念、主张、流程、规则、项目。模型只能补空着的字段。我核对材料标记是不是这次给它的,回来后再读一遍卡片,避免盖掉你刚填的内容。清单完整、有来源、没有冲突,我才允许确认。自动补完的字段,我不会直接当成正式卡片。
Activity:记录你实际在电脑上做了什么
我用 Activity 记你在电脑上做过什么。你的偏好和身份我放在事实和文件里,不从屏幕上猜。
我什么时候拍,什么时候不拍
我不按固定间隔连拍。切应用、点击、打字停下来,这三件事才会让我准备拍一张。几秒内来了好几次,我只留最能说明「你换了一段活动」的那次:切应用高于点击,点击高于打字停顿。
| 我看到什么 | 我做什么 |
|---|---|
| 你切到另一个应用 | 清掉上一张画面的比较基线,把这次排进拍摄 |
| 你点了一下 | 记下坐标和按键,排队拍 |
| 你打字后停了约 1.2 秒 | 排队拍。按键我只留位置和修饰键,不留你打出的字 |
| 大约每 12 秒 | 看画面变没变,没变不存 |
| 大约每 2 分钟 | 存一张心跳。和上一张一样也存,免得你长时间不动之后断档 |
| 大约每 12 秒看一次浏览器 | 只读 Chrome、Safari 当前标签的标题 |
这些情况我直接不拍:
- 你没开录制,或者屏幕锁着。
- 前台是密码管理器。我默认跳过钥匙串、1Password、Bitwarden、LastPass、Dashlane。焦点在上面时,我每 5 秒只记一条「这次跳过了」,不截图。
- 上一张还在拍,刚失败正在退避,或者还在几秒的合并窗口里。
画面没变我分三步丢掉,便宜的判断放前面。整图颜色哈希一样,我就当没变。颜色分布差得很小,我当成光标闪烁或时钟跳动。最后才用 160×90 的缩略图逐像素比。你超过 30 秒没有输入,我把这种检查再放稀。
我存 jpg,宽不超过 2560。macOS 上我先用屏幕采集守护进程。它失败一次,这次运行我就改用 Electron 自带的截屏,不再反复试。
我把脱敏做在文字上
我用系统自带的文字识别,语言包括英文、简体、繁体和日文。不是每张都做,默认每 3 张一次。识别出的文字我先脱敏,再入库,然后才在本地算向量。截图我留在本机,不发出去。
键盘我收得更早。全局监听只留按键位置,用来判断你是不是刚停手。你打出了什么字,我不记。
做会话分析和日报时,我发给模型的是脱敏后的识别文字,不是原图。原图我按时间降级:24 小时内留原图,一天到七天压到 1280×720,七天到三十天压到 640×360,超过三十天删掉。总量到 10GB,我清到 7.5GB。文字和向量留下,所以旧画面删了,我还能检索。
密码框我不做单独的画面打码。我靠两件事:前台是密码管理器时不拍;真拍到的画面最多留三十天。
碎片我归成一段一段的活动。小模型判断这段值不值得进长期事实,多数日常活动我就停在活动记录里。能进事实库的,我归一化后最多留 5 条候选,再走带语义判重的写入。查活动记录时,关键词和语义是两条路,不和事实召回混在一起。
日报我每 15 分钟看一次昨天写过没有,启动两分钟后先查一次。分析失败我就记失败,不编一份补上。我看到的生产记录里,这类失败大约占一半。
整理出来的记录像这样:
CodeBlock Loading...
整理后的摘要可能是“用户下午主要在开发和验证 Agent 的 Storage 模块,期间查阅了 SQLite 相关资料”。
送给模型的是脱敏后的 OCR 和事件摘要。原始截图不发。截图和 OCR 向量留在本地。
分析可以写出很长的工作日志。能进长期事实库的很少:普通活动不值得半年后再召回。归一化后最多留 5 条候选,过「值不值得记」这道门,再走带语义判重的写入。
和别的实现比,我为什么这么选
放在一起看,差在数据模型和谁来改:
| 系统 | 核心存储与组织 | 写入、整理方式 | 读取方式 |
|---|---|---|---|
| Biny | SQLite 事实 + 向量 + Markdown + 专用知识层 | 小模型提取、每日 Sleep | 每轮语义 Top-K,其他知识按需获取 |
| Codex | 状态数据库 + 分层 Markdown 记忆文件 | 两阶段后台提取与全局巩固 | 记忆摘要引导 + 渐进式读取 |
| Claude Code | 项目级 MEMORY.md + 主题 Markdown | 模型在会话中维护自动记忆 | 启动索引 + 按需读文件 |
| Mem0 | 事实条目 + 向量存储 + 元数据 | 事实提取及增删改管理 | 语义搜索、元数据过滤 |
| Letta | Memory Blocks / 文件式记忆 | Agent 主动维护 + sleep-time | 核心记忆注入、外部记忆检索 |
| OpenClaw | Markdown + SQLite 检索索引 | 对话写入 + Dreaming 整理 | 混合搜索、部分记忆自动注入 |
| Graphiti / Zep | 时序实体关系图 | 增量建图、事实失效与更新 | 混合检索 + 图遍历 |
Codex 有两阶段流水线(逐会话提取,再全局归并),Claude Code 会在会话里改项目记忆,OpenClaw 的 Dreaming 也默认凌晨三点跑。大家都有后台整理。差在记成什么、什么时候触发、读的时候怎么用。
Codex 和 OpenClaw 也用 SQLite,我也写了很多 Markdown。要看的是哪份数据说了算、一条记忆以什么为单位、谁能改、失效和并发怎么处理。Codex 留的是下一次写代码用得上的经验:仓库约定、失败过的方案、怎么验证。我这边留的是以后还要继续理解这个人。
图记忆我没用。记住稳定偏好,建关系、维护关系比多记住几条事实贵。等多跳关系和事实随时间失效变成主要问题时再上。现在是事实条目、时间锚点和 Crystal。没有 Graphiti 那种带有效区间和多跳查询的图。
mem0 可以自己托管,文件和 SQLite 也都能打开看,所以不是“为了本地才自己写”。我要把它嵌进 Biny 的消息树、时间锚点、Activity 来源开关、Crystal 清单、日记副作用恢复,还有“前台在忙,后台就别跑”。现成 SDK 给得了存储和召回,给不了这些接缝。
最后
做下来觉得费劲的不是把信息存下来。是每一条都能查出从哪来、为什么还在、什么时候会被清掉。上面几层的数据来源不一样,一次向量搜索盖不住写入、召回和清理。
模型可以提出“这两条看起来是一回事”。删不删由程序定:候选范围、来源时间、版本核对、事务、租约。模型给判断,存储层落盘。
项目地址: Biny Agent
实现索引: